Meta发布实时音频感知语音转写模型 兼顾低延迟与高准确率
Labs推出的首个实时语音转写模型。Meta表示,模型会根据不同词语的识别难度动态调整等待时间。对于较容易识别的内容,会更快完成输出;遇到更复杂的词语时,则会增加监听时间,以在识别准确率和转写延迟之间取得平衡。Transcribe还将说话人识别、说话人切换检测及语句边界判断整合在同一模型中。
Meta刚甩出枚王炸, Muse Voice令AI眼镜的耳朵就此装上了。每小时零点一八美元的定价, 加入对二十余人同场说话的精准区分, 这不仅是语音识别里的卷王, 更是为未来个人AI设备定下的新标准。
动态调整延迟机制
Meta把音频切成八十毫秒的小片段, 模型在每个片段结束时做决策。它根据词语识别的难度动态做决定是继续听还是立即输出汉字。简单词汇快些出, 复杂词汇多等会儿, 靠强化学习训练来平衡准确率和速度, 让机器更像人脑处理信息的过程。
识别精度与速度
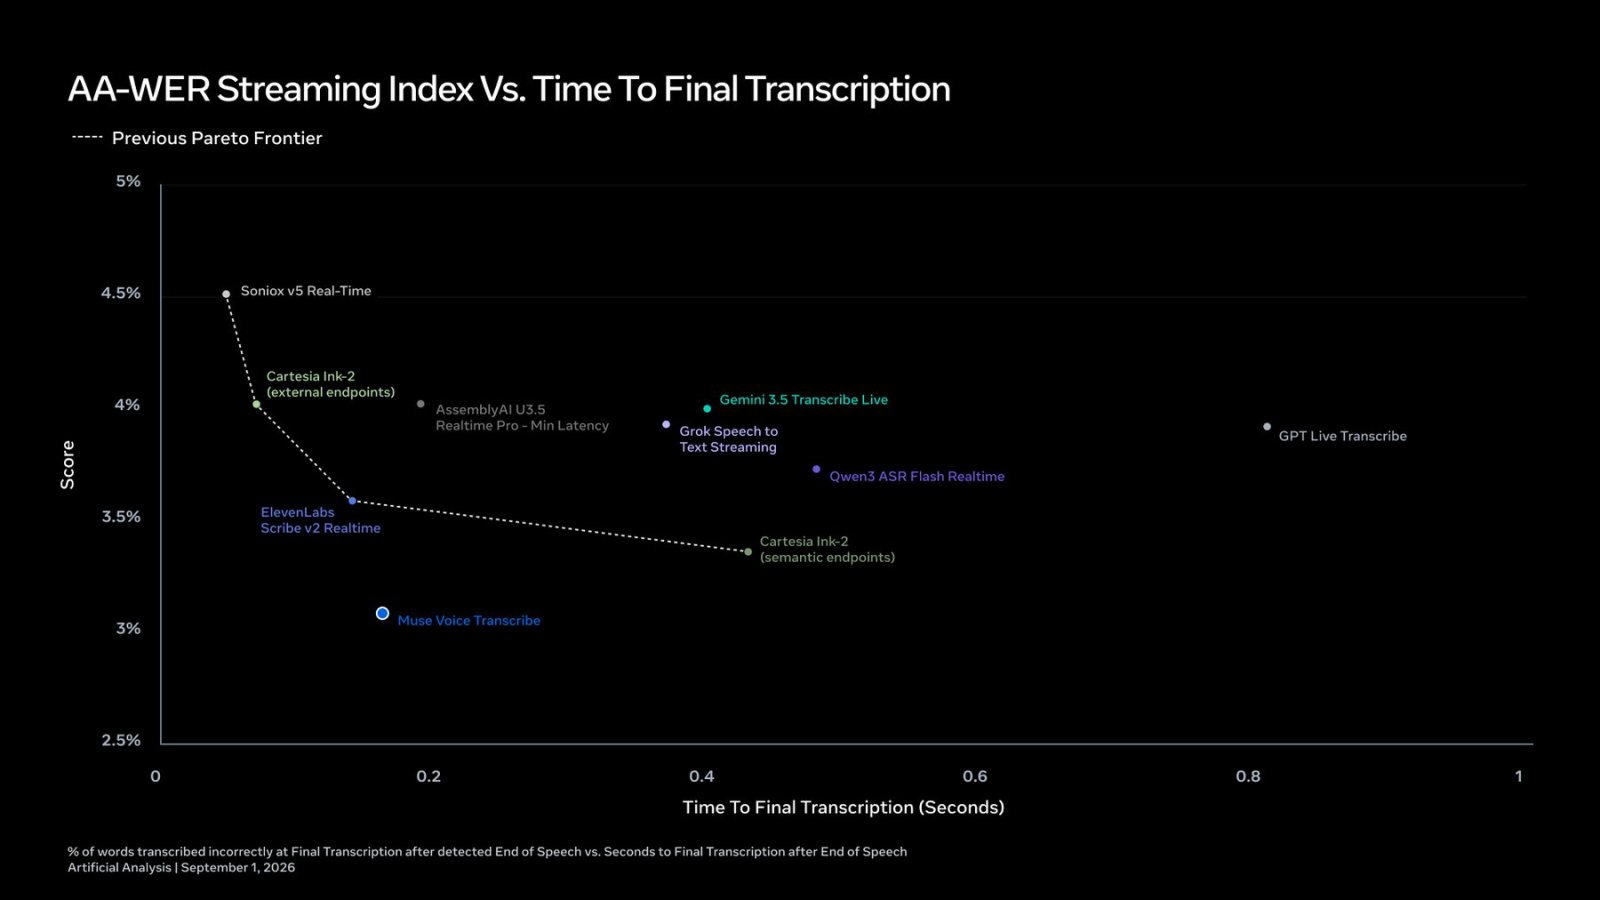
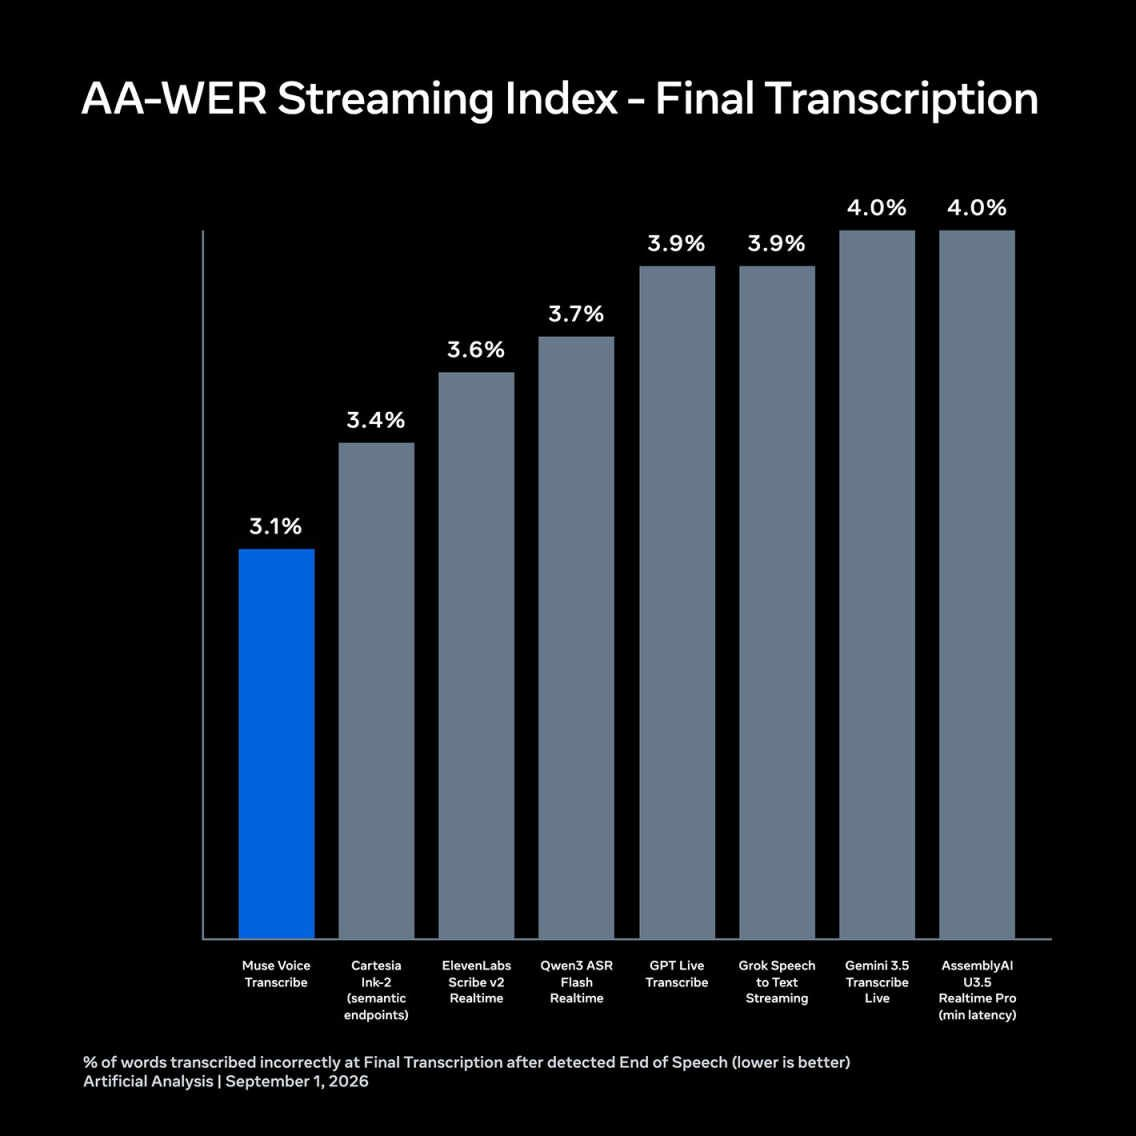
测试数据超亮眼, Muse Voice英文单词错误率仅3.1%, 比竞品低了零点五个百分点。虽说延迟零点一六秒略高于部分对手, 却换来更低的错误率。在VR陀螺的独立测试里, 这类为了准确率牺牲一点点速度的策略, 被觉着是更契合实时交互场景的取舍。
多人实时分离能力
最硬的核是同时能区分它20多个说话人, 还支持一小时以上连续录声道的音无后期处理 Meta 演示了同一空间内八人在聊天时, 模型能实时分出谁在说话 这对于嘈杂环境下会议记录或社交场景, 解决了传统语音识别的“串音”痛点和无法定位声源的问题。
多语言支持策略
覆盖七十多种语言的训练之中, 七十五种皆是经历完整测试的, 更厉害的乃是可支持一段话里头切换不同语言, 开发者能够喂入语言、 keywords或者关键词等等的上下文提示来专门提升专有名词识别的准确率, 这种灵活性让它在医疗、法律这类垂直领域当中的专业术语转写上存有着更高的可用性。
极致价格与硬件指向
每小时0.18美元, 折算下来每1000分钟才3美元, 远低于竞品的4到6.5美元。低价策略分明是冲着AI眼镜等终端设备去的, 意在让个人AI Agent能长期在线照料应答。尽管Meta没有发布模型大小和权重? 不对, 还是API, 已开放Meta, AI内外也已在用, 商业化路径那是非常清晰的。
你觉着0.18美元一小时的语音转写交易, 能让你容忍AI眼镜随时在暗地里录走分解你跟友侪的言对啊? 欢迎在评论区讲讲你的看法, 点赞分享给有需求量的好友。